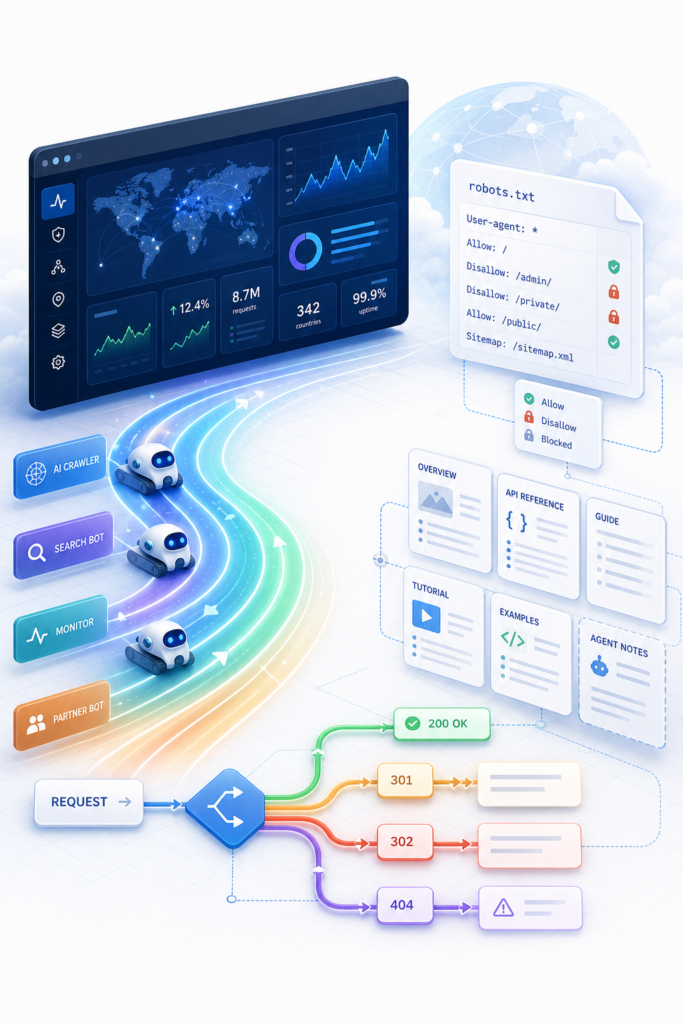
只把 AI 爬虫一刀切拦掉,已经不够用了。现在更有价值的,是先补好 robots.txt、再看 Directives、再判断哪些内容该给 agent 看、哪些训练爬虫该被引导走规范路径。
- 01先读摘要,判断是否与你的场景相关。
- 02再看来源,保留继续查证的路径。
- 03最后看步骤、风险和可复用动作。
很多内容站在处理 AI crawler 时,第一反应还是“要么全放、要么全拦”。这个思路在 2026 年已经不够用了,因为现在你面对的不只是训练爬虫,还有做搜索摘要、做 agent 输入、做链接发现的不同访问方。Cloudflare AI Crawl Control 最大的价值,不是替你做一个总开关,而是把 robots.txt、crawler 合规性、AI agent 兼容度和训练流量引导放进同一张操作台。只要顺序弄对,你会比单纯挡流量更有掌控感。
适用场景
- 你的网站已经挂在 Cloudflare 代理后,希望搞清哪些 AI 服务在碰你的内容。
- 你不想一刀切封死所有 AI crawler,而是想区分搜索、agent 和训练用途。
- 你准备补好 robots.txt 和内容信号,让真正有价值的 agent 能稳定读到正确页面。
- 你需要给编辑、SEO 或安全同事一套能重复执行的站点治理流程。
不适用场景
- 站点根本没有通过 Cloudflare 代理,或者没有权限进入对应的 dashboard。
- 你想把 AI Crawl Control 当成法律授权替代品。它能做流量治理,但不能替代合同和政策判断。
- 你的站点连基础 robots.txt 都没有,却急着讨论更高级的 redirect 细节。
- 你需要处理支付、医疗、金融等高风险敏感数据页面,这类内容更应该默认收窄暴露面。
先看产品边界:Cloudflare 现在给了哪些层
从今天可访问的官方文档看,Cloudflare 已经把 AI Crawl Control 分成几层能力。概览页负责告诉你:它能看 AI 服务访问、做细粒度 allow/block、追 robots.txt 合规性,还能延展到 pay-per-crawl。Directives 页面则进一步把重点放在 `robots.txt` 的可达性、Content Signals、违规 crawler 和 Agent Readiness 上。换句话说,它已经不是单独的“爬虫看板”,而是一套围绕 AI agent 可读性和训练流量边界的站点治理工具。
这也是为什么这篇文章不建议从“先改一条规则”开始。更稳的顺序应该是:先补基础文件,再读 Directives,再决定什么该允许、什么该引导、什么该阻断。
准备材料
- Cloudflare 对应账号和域名的 dashboard 访问权限。
- 当前线上 `robots.txt` 文件,最好知道它是否由上游、CMS 或 Cloudflare 管理。
- 站点里最重要的几类内容路径,例如文章、文档、资源页、后台和草稿区。
- 一张简单的路径表,标出哪些内容适合被搜索发现,哪些内容适合 agent 输入,哪些内容不该进入训练。
- 一个观察周期,至少 3 到 7 天,用来判断违规 crawler 和误拦。
步骤一:先把 robots.txt 可达性查清
Directives 页面第一件事看的不是“谁违规”,而是 `robots.txt` 有没有被稳定访问到。Cloudflare 文档已经提醒:如果状态是 404,先补文件;如果文件存在但请求不成功,就要排查上游 WAF 或其他安全设置。很多站点把后续所有策略讨论都建立在一个其实拿不到的 `robots.txt` 上,这一步不修,后面全是空谈。
- 打开 AI Crawl Control 的 Directives 标签,先看 status card 和 Robots.txt availability。
- 确认核心 hostname 的 `robots.txt` 返回 200 或明确可接受的成功状态,而不是 404 或被拦。
- 如果是 404,先生成最小可用版本;如果不是 404 却仍失败,排查上游安全规则或源站配置。
- 把每个 hostname 的处理状态记下来,避免主站修了、文档子域还在坏状态。
步骤二:补齐 Content Signals,不要只写老式 Disallow
Cloudflare 在 Directives 页面把 Content Signals 单独拉出来,原因很现实:`Disallow` 只能表达“别进来”,却很难表达“这个内容可以被搜索引用,但不想被训练”之类更细分的偏好。对内容站来说,最实用的做法通常是把老式 robots 指令和 Cloudflare 可管理的信号一起看,而不是二选一。
- 对公开文章区,优先明确搜索与 agent 的可见性,再决定训练态度。
- 对草稿、后台、临时资源目录,继续用明确的禁止规则,不要模糊化。
- 如果团队没空长期手写信号,可以先评估 Managed robots.txt,再决定是否交给 Cloudflare 管理。
步骤三:用 Agent Readiness 判断是不是该补 Markdown for Agents
Cloudflare 现在把 Agent Readiness 直接放进 Directives 旁边,而且评分里明确包含 `Markdown for Agents`。这说明一个现实趋势:未来不只是“要不要让 bot 进”,而是“当 agent 进来时,你给它的内容是不是适合机器稳定消费”。如果你的页面很重、结构杂、装饰层多,补 `Markdown for Agents` 往往比继续堆 prompt 更有效。
- 先跑一次 readiness,拿到当前关于 robots.txt、Content Signals 和 Markdown for Agents 的建议。
- 只对需要被 agent 稳定读取的内容类型补 Markdown for Agents,例如帮助文档、资源页、标准教程。
- 不要把所有营销页一股脑做成 agent 入口,先挑搜索意图清晰、结构稳定的页面。
- 补完后复查 readiness,确认不是只写了规则,但机器端仍拿不到清晰内容。
步骤四:把 Redirects for AI Training 当成“训练流量路径治理”,不是普通 301
Cloudflare 在 AI Crawl Control 参考里单独给了 Redirects for AI Training,这个设计本质上是在回答一个问题:当训练类 crawler 该去哪时,你是不是愿意给它一条更规范、更可控的路径,而不是放任它到处抓。对内容站来说,这比简单 block 更细,因为你可以把训练态的流量引导到更合适的 canonical 路径、资源页或许可页。
- 适合:你已经愿意暴露某些内容给训练访问,但希望入口更集中、更可审计。
- 不适合:你根本不打算给训练流量任何内容,这时保持 block 更直接。
- 做 redirect 之前,先区分训练 crawler 和搜索 crawler,别把正常搜索发现一起改坏。
步骤五:发现 robots.txt 违规 crawler 后,优先做分层处置
Directives 页面的 Robots.txt violations 列表很适合做分层处置。不要一看到违规就全站拉黑,而是先按内容敏感度、违规频率和 crawler 类型拆层:高敏感路径和持续违规者直接 block;边界模糊但仍有商业价值的,考虑 path-specific WAF 或 redirect;只是偶发误碰的,先观察。这样做,策略更容易向团队解释,也更不容易误杀正常流量。
hostname:
robots.txt 状态:
Content Signals 状态:
是否启用 Managed robots.txt:
需要补 Markdown for Agents 的路径:
训练流量引导路径:
已发现违规 crawler:
处置方式:block / WAF / redirect / observe
复查日期:
实际例子:文档站与博客站分开处理
一个团队同时运营博客站和文档站。博客站以搜索与分享为主,文档站则需要被 agent 稳定读取。团队没有再用同一套规则处理两边,而是让博客站优先补 `robots.txt` 和内容信号,文档站则额外补 Markdown for Agents,并把训练流量引导到更规范的文档路径。这样做之后,搜索和 agent 读取都更可控,编辑团队也知道哪些页面需要维护“机器可读版本”。
验收清单
- 核心 hostname 的 `robots.txt` 可稳定访问,没有 404 或异常阻断。
- Directives 页面已能看到 Content Signals 和违规 crawler 信息。
- 需要被 AI agent 消费的页面已评估 Markdown for Agents,而不是只做普通 HTML。
- 训练流量是否 block 或 redirect 已做明确决策,不再模糊。
- 违规 crawler 的处置有记录,不靠临时口头决定。
- 至少完成一轮 3 到 7 天的复查。
常见坑
- 只看 overview 数据,不进 Directives 细查 `robots.txt` 可达性。
- 把所有 AI crawler 都当同一类,结果把有价值的 agent 入口也一起挡掉。
- 想做 AI agent 友好页面,却仍给机器端暴露一整层噪音结构。
- 看到违规列表就全站封禁,没有先看路径和用途。
- redirect 规则没有和 canonical 策略一起设计,导致站点信号更乱。
排错路径
- Directives 页面显示 404:先补 `robots.txt`,再谈其他规则。
- Content Signals 缺失:检查是否启用了 Managed robots.txt 或手动补齐内容信号。
- readiness 分低:优先看 Markdown for Agents 和 robots.txt,而不是先改营销页样式。
- 违规 crawler 一直出现:去 Crawlers 或 WAF 层做更明确的 path 规则。
- 搜索流量异常:复查是否把搜索 crawler 和训练 crawler 误混到同一策略。
后续维护建议
更新日期:2026-07-25。以后每次站点结构改版、栏目迁移或资源页重构,都应该重跑一次 AI Crawl Control 的 Directives 与 readiness 视图。因为真正会过时的不是某一条 block 规则,而是你的页面结构和内容边界。把这套检查并进发布前巡检,比等日志里冒出异常访问再补要主动得多。