Cloudflare WAF Rate Limiting 规则清单:表达式、characteristics、period 和 action 怎么配
Rate limiting 规则要先确认计数对象和缓存边界,再用 Log 观察,再切到挑战或 Block。
围绕「cloudflare」的文章归档,便于从同一个关键词继续追踪相关观察。
Rate limiting 规则要先确认计数对象和缓存边界,再用 Log 观察,再切到挑战或 Block。
Access 默认拒绝所有未匹配 Allow 策略的流量,但动作顺序、session 层级和 Service Auth 才是上线关键。
Turnstile 不需要把网站代理到 Cloudflare,也能在表单、登录和提交接口上挡住批量机器人,关键是服务端必须校验 token。
Cloudflare 这轮真正改变站长决策的,不是再多一个“Block AI bots”总开关,而是 Search、Agent、Training 已经被拆成三类,而且 9 月 15 日开始新域名会吃到新的广告页默认策略。
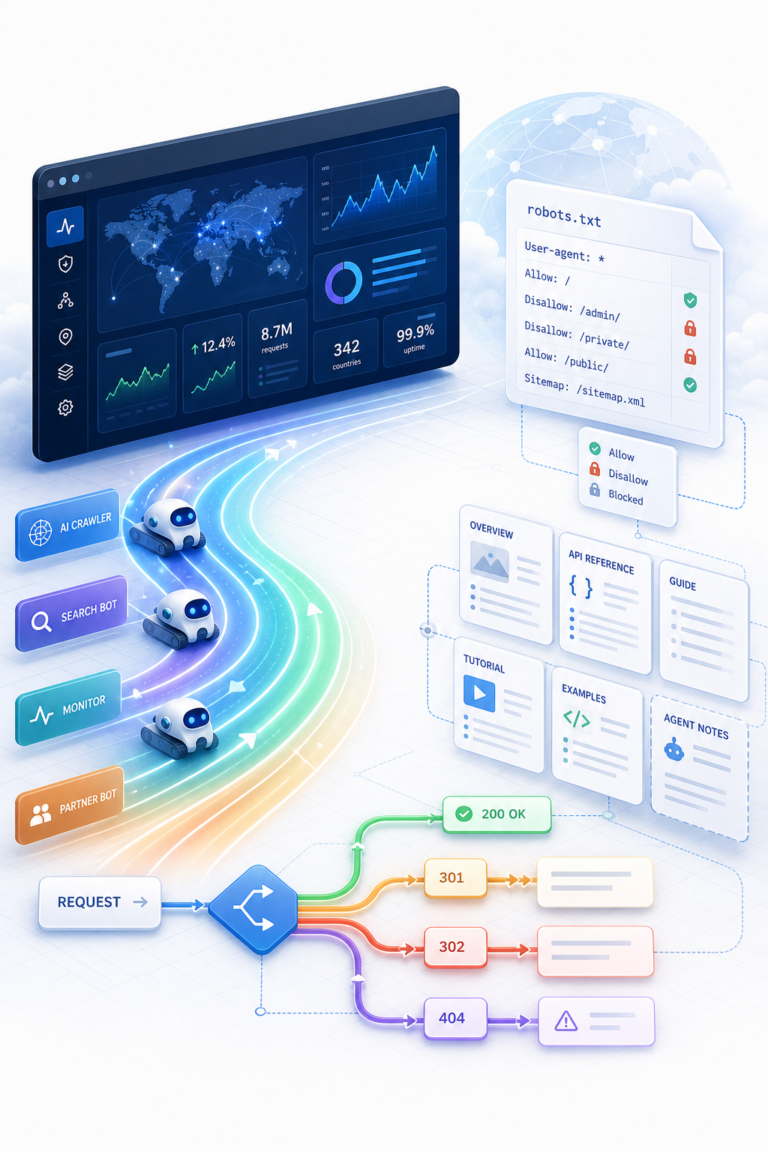
只把 AI 爬虫一刀切拦掉,已经不够用了。现在更有价值的,是先补好 robots.txt、再看 Directives、再判断哪些内容该给 agent 看、哪些训练爬虫该被引导走规范路径。

遇到 WordPress 高危漏洞周,正确顺序不是等自动更新,而是先确认 Cloudflare WAF 护住流量,再确认版本和后台内容链路。

AI 代理能把 Worker 临时部署到 Cloudflare 后,真正要管的是 60 分钟内怎么验收、怎么 claim、怎么回滚,不是把预览链接发出去就结束。

把静态站迁到 Workers Static Assets,不能只看页面能否打开。跳转、header、SPA 404、缓存命中和 workers.dev 索引边界都要验收。

AI 爬虫治理不是简单写一行 Disallow。内容站要先决定开放、声明、拦截三档边界,再用 Cloudflare 的 AI Crawl Control 和 robots.txt 做可回滚配置。

这篇文章适合想把 Cloudflare Agents SDK 0.14.0 直接接进项目的人:新版把 Browser Run、Codemode、Think 子代理和更稳的恢复链放到同一条运行路径里,能少写很多自定义编排。